Tenho notado cada vez mais conversa sobre modelos locais e resolvi pesquisar mais sobre o assunto, inclusive sobre como rodar modelos de IA no navegador. Parte dessa curiosidade veio de uma apresentação que assisti num Google I/O Extended, Web AI: da nuvem ao navegador!, do William Grasel.
Uma forma de aprender é aplicando, e foi tentando criar uma aplicação real para testar IA localmente que encontrei o Pocket TTS da Kyutai. Ele é um modelo de texto para fala com uma característica importante: foi projetado para ser executado em CPU.
O README do projeto é direto sobre isso. Diz que o modelo roda cerca de 6 vezes mais rápido que o tempo real num MacBook Air M4, usando só 2 núcleos, e que em processadores com bom desempenho por thread (como o Apple Silicon) a equipe não viu ganho ao mover o modelo para a GPU. Alguns meses antes do lançamento do Pocket TTS, o Chrome já tinha passado a rodar o Gemini Nano, o modelo de linguagem embutido no navegador, em máquinas sem placa de vídeo.
Isso me deixou com uma dúvida que é o fio deste texto: por que alguns modelos de IA já rodam no navegador sem GPU, e o que mudou para isso ser possível? A primeira resposta que vem à cabeça é “os modelos ficaram menores”. Ela está certa, mas incompleta: houve uma segunda mudança, na forma de executar esses modelos, e as duas dependem uma da outra.
O problema: IA local sempre veio com um asterisco de hardware
Por anos, “rodar IA no navegador” significou uma demo impressionante que funcionava bem na máquina de quem fez a demo. O asterisco quase nunca aparecia no título, mas estava lá: precisa de uma GPU razoável. Num notebook corporativo com vídeo integrado, a aba travava, o ventilador disparava e o resultado chegava tarde demais para ser útil.
Para um produto, isso inviabiliza a ideia. Você não escolhe o hardware de quem visita seu site. Se a funcionalidade depende de placa de vídeo dedicada, ela existe para uma fração do público, e o resto recebe um fallback para o servidor (ou nada).
Vale dizer logo: isso não ficou no passado. Muita coisa que roda local no navegador hoje ainda é experimento. O meu próprio plugin de WordPress que narra posts, o post-voice, ainda é um teste. O que mudou é que alguns modelos, para algumas tarefas, passaram a rodar em hardware comum.
Então a dúvida que me interessa aqui é mais estreita. GPU costuma ser mais rápida para IA, disso ninguém discorda. O que eu queria entender é em que tipo de tarefa uma CPU comum já dá conta, e o que precisou acontecer para isso.
Contexto histórico: as peças chegaram em camadas, não de uma vez
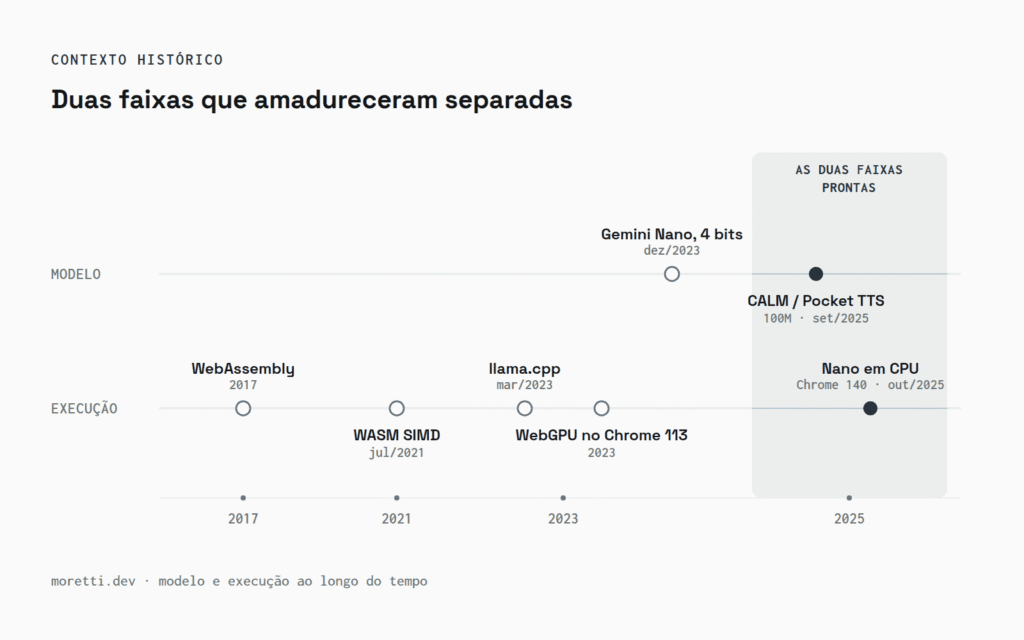
Olhando as datas, as peças amadureceram separadas, em anos diferentes:
- 2017: WebAssembly chega aos navegadores, e começa o design do WebGPU no W3C.
- Julho de 2021: SIMD de 128 bits é padronizado no WebAssembly (entra na versão 2.0 da spec). É o que permite processar vários números por instrução.
- Março de 2023: sai o primeiro commit do llama.cpp. Em semanas, um LLM de 7 bilhões de parâmetros roda em CPU de notebook com pesos de 4 bits.
- Abril/maio de 2023: Chrome 113 habilita WebGPU por padrão.
- Dezembro de 2023: o relatório técnico do Gemini 1.0 descreve o Nano: 1,8 e 3,25 bilhões de parâmetros, destilado e quantizado em 4 bits.
- Setembro de 2025: a Kyutai publica o paper do CALM, a arquitetura por trás do Pocket TTS, e o Google abre o LiteRT-LM, runtime que já roda o Gemini Nano no Chrome.
- Outubro de 2025: Chrome 140 começa a liberar o Gemini Nano em CPU no Linux, macOS e Windows.
- Novembro de 2025: WebGPU passa a ser suportado em Chrome, Edge, Firefox e Safari, ainda com lacunas por plataforma.
Repare que as peças se dividem em dois grupos. Um grupo mexe no modelo (destilação, quantização, arquitetura). O outro mexe na infraestrutura de execução (SIMD, runtimes, APIs do navegador). Guarde essa divisão, porque ela é a resposta.
Primeiras tentativas: pegar a GPU emprestada e o reflexo de “usa a GPU”
Antes do WebGPU, a única forma de usar a placa de vídeo no navegador era o WebGL, uma API feita para desenhar triângulos. Bibliotecas de ML disfarçavam matrizes como texturas e contas como shaders de pixel. Funcionava, mas era um hack, sem compute shaders de verdade. Quando o WebGPU chegou, o próprio anúncio do Chrome 113 falou em ganho de “mais de três vezes” em inferência de ML comparado ao WebGL (número do fornecedor, sem modelo ou hardware especificado).
Só que o reflexo que ficou dessa época é outro, e ele erra dos dois lados:
- “Se tem GPU, usa a GPU.” Para modelos pequenos gerando uma coisa de cada vez, isso pode não ajudar. A Kyutai justifica a ausência de ganho no Apple Silicon com duas coisas: batch size 1 e modelo muito pequeno. Batch size é o tamanho do lote, quantas entradas o modelo processa de uma vez; batch size 1 quer dizer uma entrada por vez, como uma pessoa pedindo uma frase narrada.
- “GPU nunca ajuda nesses modelos.” Também falso. O mesmo README registra que, numa máquina virtual x86 com 4 vCPUs e uma GPU Tesla T4, o Pocket TTS ficou cerca de 2,6 vezes mais rápido na GPU.
- “Quantizar sempre acelera.” Veremos adiante que, no mesmo modelo, a mesma quantização deixou o Pocket TTS mais rápido num runtime e mais lento em outro.
A resposta certa é mais chata e mais útil: depende da CPU, do tamanho do modelo e do runtime. E essa lista de variáveis já diz bastante coisa. Se o desempenho muda com cada uma delas, cada visitante do seu site vive uma experiência diferente. É por isso que tanta IA local no navegador ainda não passa de uma demo bonita: levar para produção exige medir no hardware do seu público, não no seu.
O nascimento da solução: modelo pequeno e runtime que sabe usar a CPU
Começando pelo modelo: o Pocket TTS já rodava a ~6x tempo real em CPU no lançamento, com pesos em float32, sem quantização e sem runtime especial (PyTorch comum). O que viabilizou foi o tamanho e o desenho dele: 100 milhões de parâmetros e uma arquitetura desenhada para gastar pouco.
O Gemini Nano conta a mesma história por outro ângulo. Ele nasce miniaturizado: destilado de modelos maiores e quantizado em 4 bits, segundo o relatório técnico de 2023. Sem isso, não caberia no orçamento de memória de um notebook.
Mas a infraestrutura também pesa. No Chrome, o Gemini Nano passou a rodar em CPU no Chrome 140 sem trocar o modelo nem a API. O post oficial diz que o modelo “permanece consistente” entre GPU e CPU. Ali, a barreira que caiu foi de runtime.
Então foram as duas coisas. Os modelos ficaram pequenos o suficiente, e a execução em CPU amadureceu para aproveitar isso. Um sem o outro não resolve.
Para entender por que o desempenho é tão sensível a essas duas coisas, é preciso olhar o que acontece a cada token gerado.
Como funciona: gerar um token por vez esbarra na memória antes do cálculo
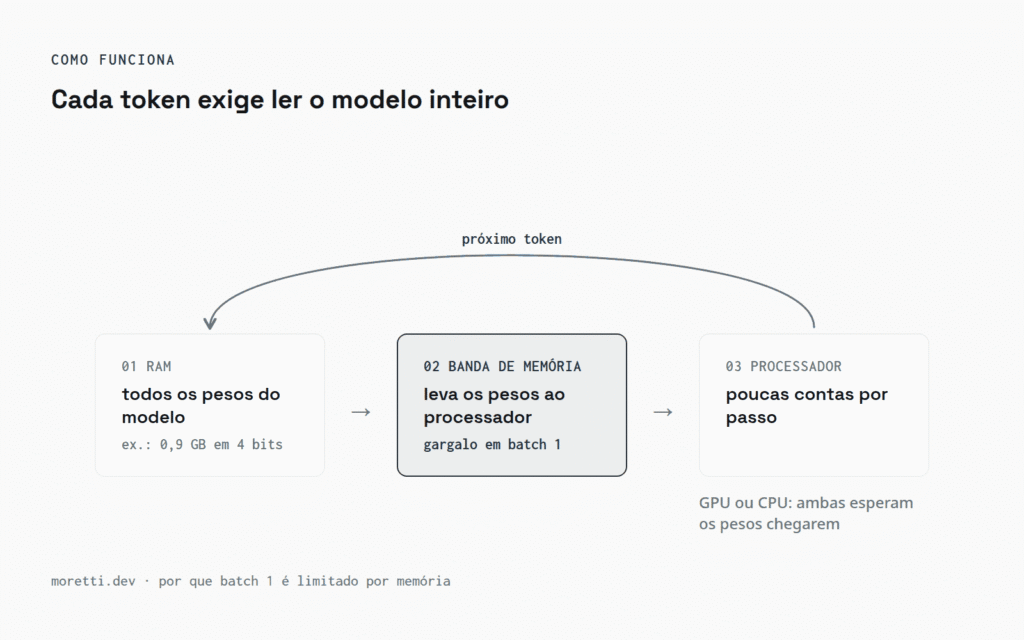
Aqui está o “aha” que, para mim, amarra tudo. Modelos generativos como LLMs e o Pocket TTS são autorregressivos: geram um pedaço, usam esse pedaço como entrada e geram o próximo. Esse pedaço é o token: parte de uma palavra num LLM, um trecho de áudio no Pocket TTS. Com um único usuário pedindo uma única resposta (o tal batch size 1), cada passo exige ler todos os pesos do modelo da memória para fazer relativamente pouca conta com eles.
GPUs são excelentes em fazer muita conta em paralelo. Mas se a conta por passo é pequena, a GPU fica esperando os dados chegarem. O gargalo passa a ser a banda de memória, a velocidade com que os pesos saem da RAM e chegam ao processador. Finbarr Timbers resumiu isso na época do llama.cpp: a banda de memória é o fator limitante em quase tudo que envolve amostrar de transformers.
A conta de guardanapo
Dá para estimar um teto de velocidade com uma divisão. O código abaixo roda em qualquer console:
// Teto teórico de tokens por segundo em batch 1:
// cada token exige ler todos os pesos uma vez.
function tetoTokensPorSegundo({ parametros, bytesPorPeso, bandaGBs }) {
  const tamanhoGB = (parametros * bytesPorPeso) / 1e9;
  return { tamanhoGB, tokensPorSegundo: bandaGBs / tamanhoGB };
}

// Números redondos, só para ilustrar a ordem de grandeza.
// 1,8 bilhão de parâmetros é a escala do Nano-1 descrito em 2023,
// não o modelo que o Chrome distribui hoje.
const banda = 100; // GB/s, hipotético

console.log(tetoTokensPorSegundo({ parametros: 1.8e9, bytesPorPeso: 4, bandaGBs: banda }));
// float32: { tamanhoGB: 7.2, tokensPorSegundo: ~13.9 }

console.log(tetoTokensPorSegundo({ parametros: 1.8e9, bytesPorPeso: 0.5, bandaGBs: banda }));
// 4 bits: { tamanhoGB: 0.9, tokensPorSegundo: ~111 }Isso é um teto, não uma medição: na vida real entram overhead do runtime, cache e o custo das contas. Mas a ordem de grandeza mostra o ponto. Reduzir o modelo de 32 para 4 bits multiplica por 8 o teto de velocidade na mesma máquina, porque há 8 vezes menos bytes para mover. É por isso que quantização e CPU andam juntas.
Para usar números da sua máquina, a banda de memória costuma estar na especificação do processador: a Apple informa 120 GB/s para o chip M4, por exemplo. Se o fabricante não publica, dá para estimar pela memória: canais × taxa de transferência (MT/s) × 8 bytes. Dois canais de DDR5-5600 dão 2 × 5600 × 8 = 89.600 MB/s, cerca de 90 GB/s de pico teórico. É uma conta para planejar antes de escolher o modelo: o navegador não expõe a banda de memória para JavaScript.
O que o runtime precisa fazer
Ter menos bytes não basta se o código que multiplica as matrizes for ingênuo. É aqui que entra a infraestrutura:
- SIMD: instruções que processam vários números de uma vez (AVX2 e AVX-512 no x86, NEON no ARM). No navegador, o equivalente é o SIMD de 128 bits do WebAssembly, padronizado em 2021, e o Relaxed SIMD, padronizado em 2024 (versão 3.0 da spec).
- Threads: dividir o trabalho entre núcleos. No WebAssembly, a proposta de threads está na fase 4 do processo de padronização: pelo menos dois navegadores já implementaram o recurso e o texto da spec está pronto, falta só o grupo de trabalho declarar consenso (a fase 5). Mesmo assim, ela está disponível nos navegadores há anos.
- Kernels específicos por arquitetura: o llama.cpp, por exemplo, mantém otimizações separadas para Apple Silicon e para x86.
Se você quiser entender como o código compilado e o modelo ONNX chegam a rodar dentro da aba, escrevi sobre isso em Como WebAssembly e ONNX permitem rodar IA dentro do navegador. Aqui o foco é outro: por que a CPU passou a bastar.
Exemplo simples: IA local no navegador com o Gemini Nano
O jeito mais curto de ver IA local em CPU é usar as APIs embutidas do Chrome. O navegador decide se roda na GPU ou na CPU; o seu código não muda.
const disponibilidade = await Summarizer.availability();
// "unavailable" | "downloadable" | "downloading" | "available"

if (disponibilidade === 'unavailable') {
  console.log('Este dispositivo não atende aos requisitos do modelo.');
} else {
  // Se o modelo ainda não foi baixado, create() precisa de um gesto
  // do usuário (clique, tecla) para iniciar o download.
  const resumidor = await Summarizer.create({
    type: 'key-points',
    format: 'plain-text',
    length: 'short',
    monitor(m) {
      m.addEventListener('downloadprogress', (e) => {
        console.log(`Baixando modelo: ${Math.round(e.loaded * 100)}%`);
      });
    },
  });

  const texto = document.querySelector('article').innerText;
  console.log(await resumidor.summarize(texto));
}Dá para testar no console do DevTools do Chrome, numa página que tenha um <article>, desde que o modelo já esteja baixado; o primeiro download precisa partir de um clique.
O detalhe que importa está em availability(). “Sem GPU” não quer dizer “qualquer máquina”. A documentação do Chrome exige, para rodar em CPU, 16 GB de RAM ou mais e 4 núcleos ou mais, além de pelo menos 22 GB livres no disco do perfil. Em GPU, a exigência é mais de 4 GB de VRAM. E a Prompt API com entrada de áudio continua exigindo GPU.
Exemplos reais: Pocket TTS e o que muda quando você traz o próprio modelo
O Pocket TTS é o caso mais didático porque foi projetado para CPU desde o início. O paper do CALM (Continuous Audio Language Models) explica a escolha: em vez de gerar muitos tokens discretos de áudio, o que obriga a gerar mais tokens para ter mais qualidade, um Transformer produz um vetor por passo e uma rede pequena gera o próximo trecho de áudio contínuo. O código usa uma thread para o modelo (torch.set_num_threads(1)) e outra para o decodificador de áudio, coerente com os 2 núcleos que o README anuncia.
Quando você leva um modelo assim para o navegador, a conta muda de lugar. Não existe API embutida; você traz o modelo e o runtime. O README do Pocket TTS lista implementações comunitárias que rodam no navegador via ONNX Runtime Web, e uma delas publica os pesos em duas versões (pacote em inglês english_2026-04):
| Grafo | float32 | int8 |
|---|---|---|
| flow_lm_main | 302,7 MB | 76,3 MB |
| flow_lm_flow | 39,1 MB | 10,0 MB |
| mimi_decoder | 41,5 MB | 22,7 MB |
| mimi_encoder | 39,8 MB | 20,8 MB |
| text_conditioner | 16,4 MB | 16,4 MB |
| Total | ~440 MB | ~146 MB |
Para quem vai baixar isso numa aba, a diferença entre 440 e 146 MB é a diferença entre um produto usável e uma tela de loading.
O text_conditioner não encolhe porque essa exportação quantiza só as multiplicações de matrizes (operadores MatMul), e esse grafo não foi afetado por ela.
Para ouvir isso rodando na sua máquina, o @KevinAHM mantém uma demo no Hugging Face que executa o Pocket TTS inteiro no navegador, em CPU, com os modelos int8 e pacote em português. A página é servida com os mesmos cabeçalhos de cross-origin isolation que aparecem mais abaixo, então é um bom lugar para ver crossOriginIsolated valendo true.
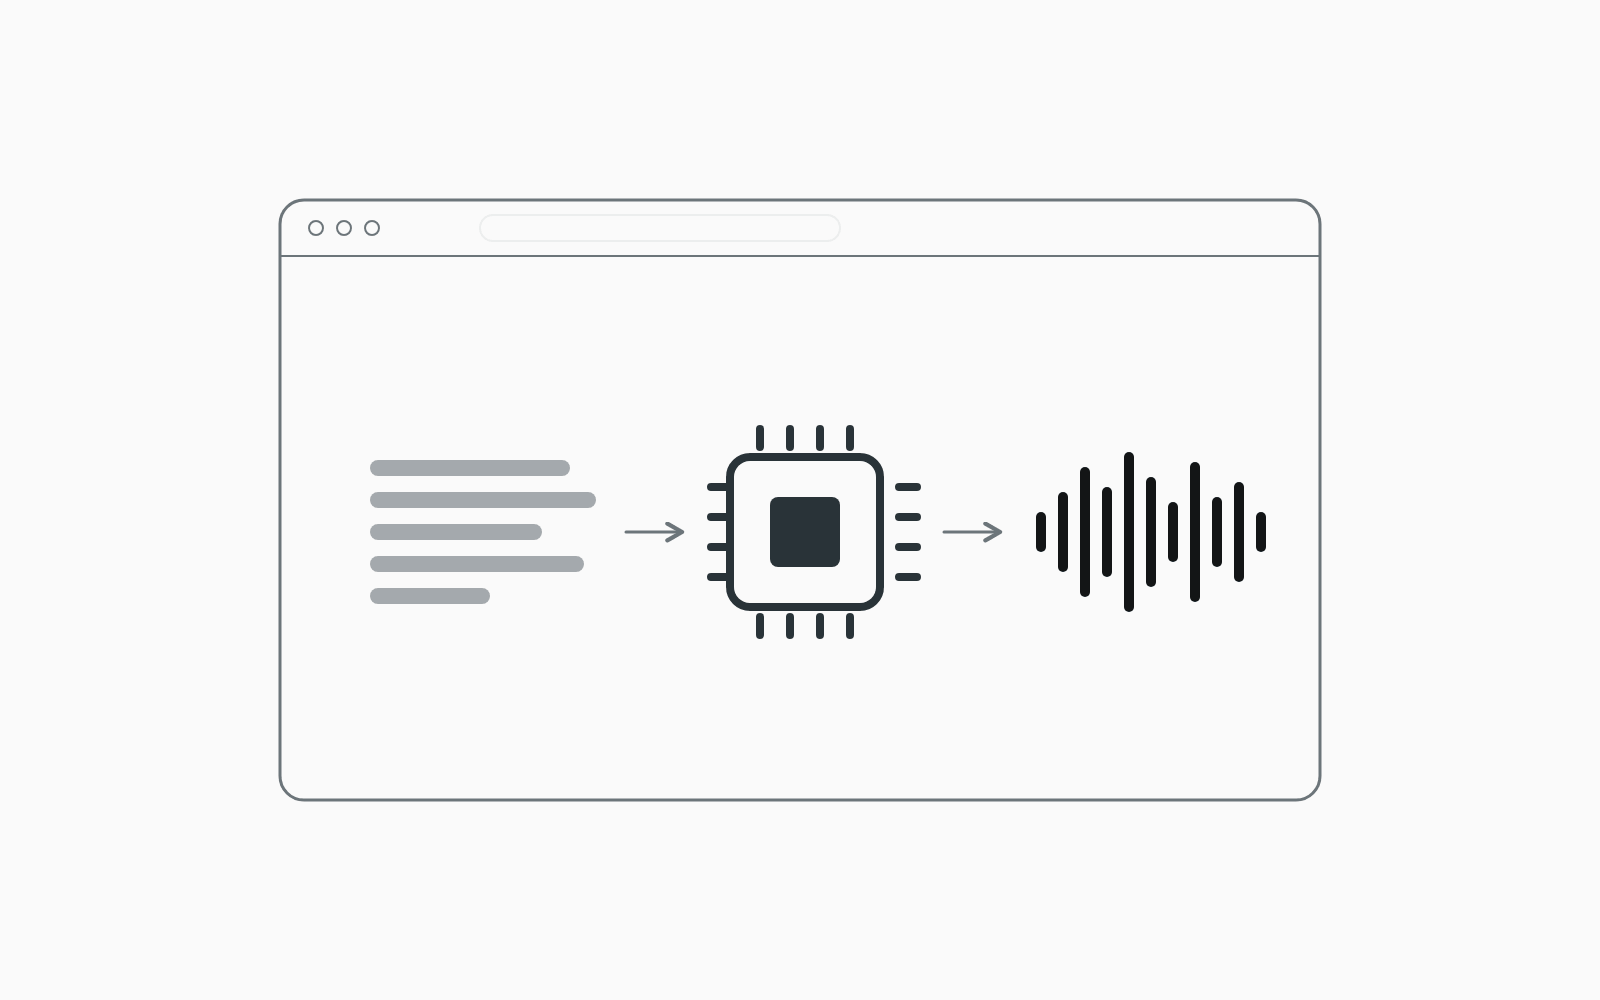
É com esse tipo de pipeline que estou experimentando no post-voice, o plugin que citei no começo, que narra posts usando Pocket TTS dentro do navegador, só com CPU e WebAssembly, sem WebGPU. Ele usa a implementação para navegador do @KevinAHM. Ainda não tenho medições que mereçam virar número aqui; os detalhes de arquitetura ficam para um próximo artigo.
Uma configuração mínima com ONNX Runtime Web deixa visível onde a infraestrutura aparece no seu código:
import * as ort from 'onnxruntime-web';

// Sem cross-origin isolation, o ONNX Runtime Web roda em uma thread só.
console.log('crossOriginIsolated:', self.crossOriginIsolated);

// Loop autorregressivo = matmuls pequenas e sequenciais.
// Mais threads nem sempre ajudam; limitar pode render mais.
ort.env.wasm.numThreads = Math.min(navigator.hardwareConcurrency ?? 1, 4);

// Um dos 5 grafos do Pocket TTS, só para mostrar a configuração.
const sessao = await ort.InferenceSession.create('/modelos/flow_lm_main_int8.onnx', {
  executionProviders: ['wasm'],
});E, para crossOriginIsolated ser true, o servidor precisa enviar dois cabeçalhos:
Cross-Origin-Opener-Policy: same-origin
Cross-Origin-Embedder-Policy: require-corpEsquecer esses cabeçalhos é uma das formas mais silenciosas de deixar a CPU ociosa: a documentação do ONNX Runtime diz que o multi-threading só é habilitado quando o navegador suporta threads em WebAssembly e a página está em modo crossOriginIsolated.
Performance: quantizar nem sempre acelera, e a GPU ainda vence em alguns cenários
O dado mais revelador sobre isso está no PR #147 do Pocket TTS, que adicionou quantização int8. Mesmo modelo, mesma configuração de quantização (a padrão do PR), média de 10 execuções. Atenção aos nomes: torch.ao é o módulo de quantização embutido no PyTorch; torchao é uma biblioteca separada, mais nova.
| Máquina e runtime | Antes (x tempo real) | Depois int8 | Variação |
|---|---|---|---|
| x86, torch.ao (FBGEMM) | 3,17x | 4,04x | +27% |
| Apple M4, torch.ao (QNNPACK) | 6,40x | 5,36x | −16% |
| Apple M4, torchao | 6,33x | 7,76x | +23% |
A memória caiu de 450 MB para 234 MB (48% a menos) em todos os casos. A velocidade dependeu de existir um kernel int8 bom para aquela CPU. No QNNPACK, o custo de desquantizar cada operação (converter os valores de volta para ponto flutuante antes da conta) em batch 1 comeu o ganho. É o exemplo mais claro de que tamanho e runtime são interdependentes: a mesma miniaturização pode acelerar ou atrasar.
Já a GPU volta a valer quando a CPU é o elo fraco. Na VM x86 de 4 vCPUs, o Pocket TTS foi de ~2,3x a 2,5x tempo real em CPU para ~6,28x numa Tesla T4, com pico de 560 MB de VRAM. Para o Gemini Nano, o Google diz que a inferência é “tipicamente mais rápida” em GPU, mas não publica números de tokens por segundo em CPU. Essa é uma lacuna: não há benchmark oficial publicado comparando os dois caminhos no Chrome.
Quando NÃO usar IA local no navegador
Rodar em CPU no cliente resolve um conjunto específico de tarefas. Fora dele, o servidor continua sendo a arquitetura certa, e não por falta de otimização:
- Muitos usuários ou muitas requisições em lote. O argumento de banda de memória vale para batch 1. Quando você processa muitas entradas juntas, a conta por passo cresce e a GPU volta a ter trabalho para os seus núcleos. Esse é o cenário de servidor.
- Modelos grandes. O teto de velocidade cai na proporção do tamanho. Um modelo que não cabe confortavelmente na RAM do usuário não é candidato.
- Público com hardware modesto. Os requisitos do Gemini Nano em CPU (16 GB de RAM, 4 núcleos, 22 GB livres) excluem boa parte dos notebooks de entrada. Chrome no Android e no iOS não tem as APIs embutidas.
- Resultado idêntico em todos os navegadores. As APIs embutidas são do Chrome. E o suporte a WebGPU, embora presente nos quatro navegadores principais desde novembro de 2025, ainda aparece como “em progresso” em plataformas como Linux e Android no Firefox e Linux no Chrome.
- Download inicial pesado. Mesmo em int8, 146 MB é muito para uma funcionalidade usada uma vez.
Comparações: modelo embutido do navegador vs trazer o próprio modelo
As duas abordagens resolvem problemas diferentes:
- Gemini Nano embutido (Chrome): zero download por site, porque o modelo é compartilhado pelo navegador; o Chrome escolhe GPU ou CPU; a API é pequena (Summarizer, Prompt API e afins). Em troca, você não escolhe o modelo, não sabe o tamanho exato dele (a doc manda consultar
chrome://on-device-internals) e fica restrito ao Chrome desktop. - Traga seu próprio modelo (ONNX Runtime Web, Transformers.js, WebLLM): você escolhe o modelo, a quantização e o backend (WASM ou WebGPU; o WebLLM exige WebGPU), e funciona em outros navegadores. Em troca, você paga o download, configura cross-origin isolation e herda a responsabilidade de testar em hardware variado.
Nenhuma das duas substitui o servidor; são uma opção a mais para tarefas pequenas e pontuais, de um usuário por vez.
Conclusão: duas barreiras caíram juntas
Voltando à pergunta do começo: por que alguns modelos de IA já rodam no navegador sem GPU?
Mudaram duas coisas, e a conta de banda de memória mostra por que precisavam mudar juntas. Os modelos encolheram: 100 milhões de parâmetros no Pocket TTS, destilação e 4 bits no Gemini Nano, arquiteturas que geram menos passos. E a execução em CPU amadureceu: SIMD no WebAssembly, runtimes como llama.cpp, ONNX Runtime Web e LiteRT-LM, kernels ajustados por arquitetura. Em batch 1, o gargalo é mover pesos, não fazer contas, e nesse regime uma CPU moderna com um modelo pequeno compete com a GPU.
Se você tem uma tarefa que cabe nesse perfil, vale medir se IA local no navegador resolve antes de assumir que precisa de GPU. Rode a conta de guardanapo com o tamanho do seu modelo, confira crossOriginIsolated na sua página e compare WASM com WebGPU no hardware do seu público, não no seu.
Referências
Especificações
- WebAssembly, propostas finalizadas (SIMD, Relaxed SIMD): https://github.com/WebAssembly/proposals/blob/main/finished-proposals.md
- WebAssembly, propostas ativas (Threads): https://github.com/WebAssembly/proposals/blob/main/README.md
- WebAssembly SIMD: https://github.com/WebAssembly/simd/blob/main/proposals/simd/SIMD.md
- WebGPU Editor’s Draft: https://gpuweb.github.io/gpuweb/
- WebAssembly, fases do processo de propostas: https://github.com/WebAssembly/meetings/blob/main/process/phases.md
Documentação oficial
- Chrome, Get started with built-in AI (requisitos de hardware): https://developer.chrome.com/docs/ai/get-started
- Chrome, Summarizer API: https://developer.chrome.com/docs/ai/summarizer-api
- Chrome, suporte a CPU para o Gemini Nano: https://developer.chrome.com/blog/gemini-nano-cpu-support
- Chrome, lançamento do WebGPU (Chrome 113): https://developer.chrome.com/blog/webgpu-release
- web.dev, WebGPU suportado nos principais navegadores: https://web.dev/blog/webgpu-supported-major-browsers
- Apple, anúncio do chip M4 (banda de memória): https://www.apple.com/newsroom/2024/05/apple-introduces-m4-chip/
- Kyutai, Pocket TTS: https://kyutai.org/tts/
- ONNX Runtime Web, env flags e session options: https://onnxruntime.ai/docs/tutorials/web/env-flags-and-session-options.html
Código-fonte
- Pocket TTS (README, seção Running on GPU): https://github.com/kyutai-labs/pocket-tts
- Pocket TTS, PR #147 (quantização int8): https://github.com/kyutai-labs/pocket-tts/pull/147
- Pocket TTS, PR #213 (medições em GPU): https://github.com/kyutai-labs/pocket-tts/pull/213
- llama.cpp: https://github.com/ggml-org/llama.cpp
- pocket-tts-onnx-export (comunidade): https://github.com/KevinAHM/pocket-tts-onnx-export
- Pocket TTS ONNX Web Demo (comunidade): https://huggingface.co/spaces/KevinAHM/pocket-tts-web
- post-voice (plugin WordPress, experimental): https://github.com/luigi-moretti/post-voice
Papers e artigos de criadores
- Kyutai, “Continuous Audio Language Models”: https://arxiv.org/abs/2509.06926
- Google DeepMind, “Gemini: A Family of Highly Capable Multimodal Models”: https://arxiv.org/abs/2312.11805
- Google Developers Blog, LiteRT-LM: https://developers.googleblog.com/on-device-genai-in-chrome-chromebook-plus-and-pixel-watch-with-litert-lm/
- Finbarr Timbers, “How is LLaMa.cpp possible?”: https://finbarr.ca/how-is-llama-cpp-possible/
- William Grasel, “Web AI: da nuvem ao navegador!” (slides): https://slides.com/williamgrasel/web-ai-da-nuvem-ao-navegador
Nota de transparência: este artigo foi produzido com auxílio de ferramentas de IA (pesquisa e redação), com revisão e decisões editoriais do autor.