Um modelo de IA treinado em Python, com pesos que ocupam centenas de megabytes, termina rodando dentro de uma aba de navegador. Sem servidor, sem API externa, sem instalar nada. A explicação mais comum para isso é simples demais: “o navegador ficou mais rápido”. Só que velocidade não é a peça que faltava.
A resposta está em dois formatos que a maioria dos desenvolvedores frontend usa sem nunca ter olhado por dentro: WebAssembly, que define como código compilado roda dentro do navegador, e ONNX, que define como um modelo de machine learning é descrito de um jeito que qualquer runtime consegue executar. Nenhum dos dois é mágica. Os dois resolveram problemas concretos, em anos diferentes, para pessoas diferentes, e só quando colocados lado a lado explicam por que hoje é tecnicamente viável rodar um modelo de IA de verdade dentro do navegador, pra um conjunto específico de tarefas.
Este artigo reconstrói essa história: de onde vem WebAssembly, por que ele não é “JavaScript mais rápido”, como ONNX resolve um problema completamente diferente, e onde essa combinação já roda em produção hoje, e onde ainda não deveria.
O problema: rodar no servidor e rodar no navegador não são a mesma decisão
Processar um modelo de IA num servidor dedicado e processar o mesmo tipo de tarefa dentro do navegador de quem visita o site não são duas formas de resolver o mesmo problema. São arquiteturas diferentes, para situações diferentes, com recursos e limites diferentes. Um servidor dá acesso a GPU dedicada, escala sob demanda e não depende de nada além da própria infraestrutura. O navegador elimina a viagem de rede e o custo de infraestrutura por requisição, mas fica limitado ao hardware de quem está usando o site naquele momento, que pode ser um notebook recente ou um Chromebook de escola.
Essa segunda opção, durante a maior parte da história do navegador, nem chegava a ser considerada séria para um modelo de qualquer tamanho relevante. Não por preguiça de arquitetura. Por limitação técnica real: sem um jeito eficiente de rodar código compilado dentro do navegador, e sem um formato comum pra descrever o modelo em si, a conta simplesmente não fechava. Entender o que mudou exige separar duas coisas que a frase “roda no navegador” costuma misturar: a velocidade de execução do código, e o formato em que o modelo é descrito.
Quando a conta fecha, rodar no cliente traz vantagens que nenhum servidor oferece de graça:
- Privacidade: o dado processado (texto, áudio, imagem) nunca sai da máquina de quem está usando. Não existe requisição de rede carregando conteúdo sensível pra um serviço terceiro processar e, potencialmente, guardar.
- Custo: sem chamada de API cobrada por uso, sem conta de tokens ou requisições que cresce junto com o tráfego. O custo computacional é pago pelo dispositivo de quem usa, não pela infraestrutura de quem publica.
- Funciona offline: depois que o modelo é baixado e cacheado pelo navegador, a inferência não depende mais de conexão. Relevante em qualquer cenário onde a rede é instável, cara, ou simplesmente indisponível no momento do uso.
Vale marcar isso desde já: mesmo com WebAssembly e ONNX resolvidos, e mesmo com essas vantagens reais, rodar IA no cliente continua limitado pelo hardware de quem visita o site. Isso restringe a modelos menores e a tarefas com propósito específico, não substitui infraestrutura de servidor para cargas de trabalho pesadas ou modelos grandes.
Contexto histórico: de asm.js ao formato binário
A história começa em 21 de março de 2013, quando Luke Wagner, da Mozilla, anunciou o asm.js: “a low-level, highly-optimizable subset” de JavaScript. Era JavaScript de verdade, só que um subconjunto estritamente tipado que o motor do Firefox (o compilador OdinMonkey, na época) reconhecia e otimizava de forma agressiva. A motivação era permitir que código C/C++ compilado via Emscripten rodasse no navegador perto da velocidade nativa, sem depender de plugins como o NaCl do Google, que exigiam binários específicos de cada sistema operacional.
Os números eram bons para a época: benchmarks internos da Mozilla, publicados no fim de 2013, mostravam asm.js rodando entre 1,5x e 2x mais devagar que código nativo em testes como Bullet e Box2D. O problema não era a velocidade de execução. Era o formato.
asm.js continuava sendo texto JavaScript. Antes de qualquer otimização acontecer, o navegador precisava baixar, parsear e tokenizar esse texto como se fosse JavaScript comum, só então reconhecer o padrão “use asm” como um caso especial. Para aplicações grandes, isso significava tempo de carregamento proporcional ao tamanho do texto, não ao tamanho real do trabalho computacional.
WebAssembly nasceu diretamente dessa limitação. Segundo o resumo histórico mantido pela comunidade do projeto, “compiler and browser makers’ experience with asm.js influenced the development of WebAssembly, which has largely supplanted asm.js since its release“. A mudança central de design não foi “deixar o JavaScript mais rápido”. Foi trocar texto por um formato binário próprio, independente de qualquer linguagem de origem, mais rápido de parsear e compilar.
O consenso de design da primeira versão (MVP) não aconteceu numa data única, embora seja comum resumir como 2017. Em 28 de fevereiro daquele ano, o post oficial da Mozilla Hacks registrou que “the four major browsers announced their consensus that the MVP of WebAssembly is complete“. Em 13 de novembro, um comunicado de imprensa da própria Mozilla confirmou que Chrome, Firefox, Edge e Safari já tinham suporte a WebAssembly rodando em produção, simultaneamente, nos quatro motores. Só em dezembro de 2019 o WebAssembly Core Specification virou W3C Recommendation, tornando-se formalmente a quarta linguagem da web ao lado de HTML, CSS e JavaScript.
Enquanto isso, um problema paralelo e completamente diferente estava sendo resolvido do outro lado da indústria: como fazer um modelo treinado num framework rodar em outro.
Primeiras tentativas: rodar inferência sem sair do JavaScript puro
Antes de WebAssembly virar rota padrão para inferência de machine learning no navegador, a alternativa era rodar tudo em JavaScript puro. O próprio time do TensorFlow.js documentou por que isso não escalava: o backend “CPU” (JS puro) do projeto “operations are implemented in vanilla JavaScript, which makes them less parallelizable, and they also block the UI thread“. Cada operação matemática do modelo virava um loop JavaScript comum, sem paralelismo real e competindo pela mesma thread que renderiza a interface.
Quando o backend WebAssembly do TensorFlow.js foi lançado em produção, em março de 2020, o próprio anúncio oficial trouxe o número: “we’ve found the WASM backend to be 10 a 30x faster than the plain JS (CPU) backend across our models“, medido em modelos reais como MobileNet, BlazeFace e PoseNet. Para um pipeline com mais de um modelo em sequência, essa diferença não é detalhe de otimização. É a diferença entre um recurso funcionar de forma aceitável ou travar a aba enquanto processa.
O outro lado do problema, o de portabilidade de modelo, tinha sua própria tentativa ingênua: cada framework de machine learning (PyTorch, Caffe2, Cognitive Toolkit) guardava o modelo treinado no seu próprio formato interno. Usar um modelo treinado em PyTorch dentro de uma aplicação construída sobre outro framework exigia reescrever a arquitetura do zero, ou depender de conversores frágeis e específicos, mantidos por terceiros.
O nascimento da solução: dois formatos para dois problemas diferentes
WebAssembly resolve o problema de execução. A própria especificação define o formato como “a safe, portable, low-level code format designed for efficient execution and compact representation“, descrevendo-o, em seu núcleo, como “a virtual instruction set architecture (virtual ISA)“. O ponto central: WebAssembly não privilegia nenhuma linguagem, modelo de programação ou modelo de objetos. Ele é um alvo de compilação. Qualquer linguagem com um compilador capaz de gerar esse formato binário pode rodar dentro do navegador, na mesma sandbox de segurança que já protege JavaScript.
ONNX resolve o problema de portabilidade. Foi anunciado por Facebook e Microsoft em 7 de setembro de 2017, com o objetivo declarado de simplificar a conversão de modelos entre frameworks rivais. Em dezembro do mesmo ano, a versão 1.0, já classificada como “production-ready”, chegou com a AWS somando-se como terceiro parceiro, ao lado de Caffe2, Cognitive Toolkit, Apache MXNet e NVIDIA TensorRT. O post oficial da engenharia da Meta resume a motivação: “create an AI ecosystem that gives developers the freedom to innovate by providing the ability to combine tools and easy transfer models“. ONNX não é um mecanismo de execução. É um grafo de operadores, um contrato: descreve o que um modelo faz, independente de onde ele foi treinado ou onde vai ser executado.
Nenhum dos dois formatos, sozinho, coloca um modelo de IA rodando no navegador. Juntos, sim.
Como funciona: da spec ao motor do navegador
Um modelo .onnx é, na prática, um grafo serializado: uma lista de operações matemáticas (convoluções, multiplicações de matriz, ativações) e como elas se conectam. Esse grafo não sabe, nem precisa saber, onde vai ser executado.
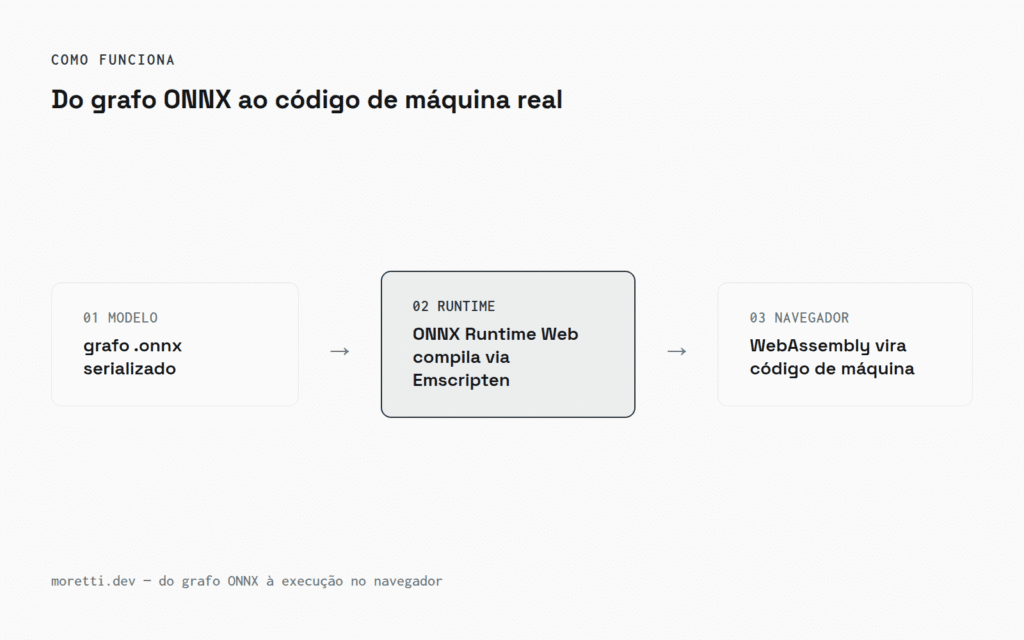
Quem executa é o runtime. O ONNX Runtime Web faz isso compilando o motor C++ nativo do ONNX Runtime para WebAssembly usando Emscripten, o mesmo compilador que originou o próprio asm.js. Não é uma reimplementação em JavaScript das operações do modelo: é o código C++ real, o mesmo que roda em servidor, compilado para o formato binário que o navegador consegue executar com segurança, dentro de uma sandbox isolada da máquina do usuário.
O motor do navegador (V8 no Chrome, SpiderMonkey no Firefox) recebe esse binário WebAssembly e compila para código de máquina real, não interpreta como faz com JavaScript comum. É essa etapa, ausente no fluxo do asm.js baseado em texto, que elimina o custo de parsear e tokenizar um arquivo grande antes de começar a executar.
Exemplo simples: carregar e rodar um modelo .onnx
O código abaixo mostra o fluxo mínimo com onnxruntime-web: carregar um modelo pequeno e rodar uma inferência.
import * as ort from 'onnxruntime-web';

async function runInference() {
  const session = await ort.InferenceSession.create('modelo.onnx');

  const inputTensor = new ort.Tensor('float32', new Float32Array([1, 2, 3, 4]), [1, 4]);
  const feeds = { input: inputTensor };

  const results = await session.run(feeds);
  console.log(results.output.data);
}

runInference();Não há nada aqui sobre “como” o modelo é executado por baixo. InferenceSession.create carrega o grafo ONNX, decide o backend disponível (WebAssembly por padrão, WebGPU quando configurado) e devolve uma sessão pronta para rodar. Essa separação entre “descrever o modelo” (ONNX) e “executar o modelo” (o runtime compilado para WASM) é exatamente o ponto central deste artigo.
Exemplo real: da demo de laboratório à produção em escala
O caso mais verificável de IA rodando no navegador, em produção, para milhões de pessoas ao mesmo tempo, é o desfoque e a substituição de fundo do Google Meet. Um post oficial do Google Research detalha a arquitetura: o pipeline inteiro roda no cliente, sem servidor, usando MediaPipe. Os autores são diretos sobre onde o trabalho pesado acontece: “all compute-heavy operations are implemented in C++/OpenGL and run within the browser via WebAssembly“. O modelo de segmentação usado no cenário de maior qualidade tem 400KB depois de quantizado, e a inferência sozinha leva 8,3ms num MacBook Pro 2018 (cerca de 120 quadros por segundo). Vale uma ressalva de precisão: esse pipeline específico usa TensorFlow Lite via XNNPACK, não ONNX, mas o princípio de execução é o mesmo: modelo pequeno, compilado pra WebAssembly, rodando inteiramente no navegador de quem está na chamada.
É esse tipo de caso, real e medido, que sustenta a afirmação de que rodar IA no navegador deixou de ser demonstração de laboratório. Não é o único formato de modelo (ONNX, TFLite e outros competem nesse espaço) nem substitui servidor pra tudo, mas prova que a arquitetura funciona em escala, com números públicos.
Um projeto bem menor que este blog documenta é outro exemplo do mesmo princípio, ainda em estágio bem diferente: um plugin WordPress de narração de posts, hoje experimental e em desenvolvimento, que decidiu encadear cinco modelos ONNX diferentes (um condicionador de texto, dois estágios de um modelo de fluxo autoregressivo, um encoder e um decoder de áudio) inteiramente dentro de um Web Worker no navegador do autor, sem nunca enviar o texto do post pra fora da máquina de quem escreveu. Esse pipeline específico, e as decisões de arquitetura por trás dele, é o assunto dos próximos artigos desta série.
Performance: os números, incluindo os que desmentem o exagero
Vale separar três comparações diferentes, porque misturá-las é a fonte mais comum de afirmação vaga sobre “WebAssembly ser rápido”.
WebAssembly contra JavaScript puro, no contexto específico de inferência: o TensorFlow.js documentou ganho de 10 a 30x ao trocar o backend JS puro pelo backend WASM, variando por modelo (MobileNet ficou entre 3x e 11,5x mais rápido; um detector de rosto leve chegou a 19,8x). Para modelos leves, o desempenho do backend WASM chega perto do backend WebGL (que usa GPU); para modelos maiores, o WebGL continua muitas vezes mais rápido.
WebAssembly contra código nativo, sem passar por JavaScript: aqui o marketing costuma exagerar. Um estudo apresentado na USENIX ATC’19, que rodou o conjunto de benchmarks SPEC CPU, mediu WebAssembly em média 45% mais lento que código nativo no Firefox e 55% mais lento no Chrome, com picos de até 2,5x de desaceleração no Chrome em alguns casos. “Quase nativo” é uma simplificação. Rápido o suficiente para a maioria dos casos de uso do navegador, sim. Idêntico a C compilado, não.
asm.js contra código nativo, para efeito histórico: os benchmarks internos da Mozilla, de dezembro de 2013, mostravam entre 1,5x e 2x mais devagar que nativo, dependendo da otimização de ponto flutuante aplicada.
Dois recursos chegaram bem depois do MVP de WebAssembly e valem menção porque moldam o que é viável hoje. Operações vetoriais (SIMD) só foram habilitadas por padrão no Chrome 91, em maio de 2021. Threads com memória compartilhada chegaram ao Chrome 74, em abril de 2019. Paralelismo real em WebAssembly não veio de graça junto com o formato em 2017. Foi construído ano a ano, em cima da base binária original.
Limitações: o que WebAssembly não resolve sozinho
WebAssembly não dá acesso a GPU por conta própria. Para isso, é preciso WebGPU, uma API separada, com seu próprio processo de padronização. WebAssembly continua sendo o alvo de execução em CPU; WebGPU é o caminho quando o modelo se beneficia de paralelismo massivo em hardware gráfico.
O tamanho do modelo continua sendo o gargalo real na maioria dos casos práticos. Trocar o formato de execução não reduz os megabytes que um modelo de IA precisa para descrever seus próprios pesos. Um pipeline de vários modelos ONNX, como o do exemplo anterior, ainda depende de download e cache eficientes antes de qualquer ganho de WebAssembly fazer diferença perceptível para quem usa o produto.
E, como os números da seção anterior deixam claro, WebAssembly não é substituto de código nativo compilado especificamente para uma plataforma. Para cargas de trabalho onde cada milissegundo importa em produção de alta escala, a diferença de 45% a 55% medida pelo estudo da USENIX ainda é real. E o exemplo do Google Meet funciona porque o modelo é pequeno (400KB) e a tarefa é bem específica (segmentação de pessoa em vídeo). Nada aqui sugere que um modelo de bilhões de parâmetros vai rodar do mesmo jeito na máquina de um visitante qualquer.
Comparações: WebAssembly e WebGPU não competem entre si
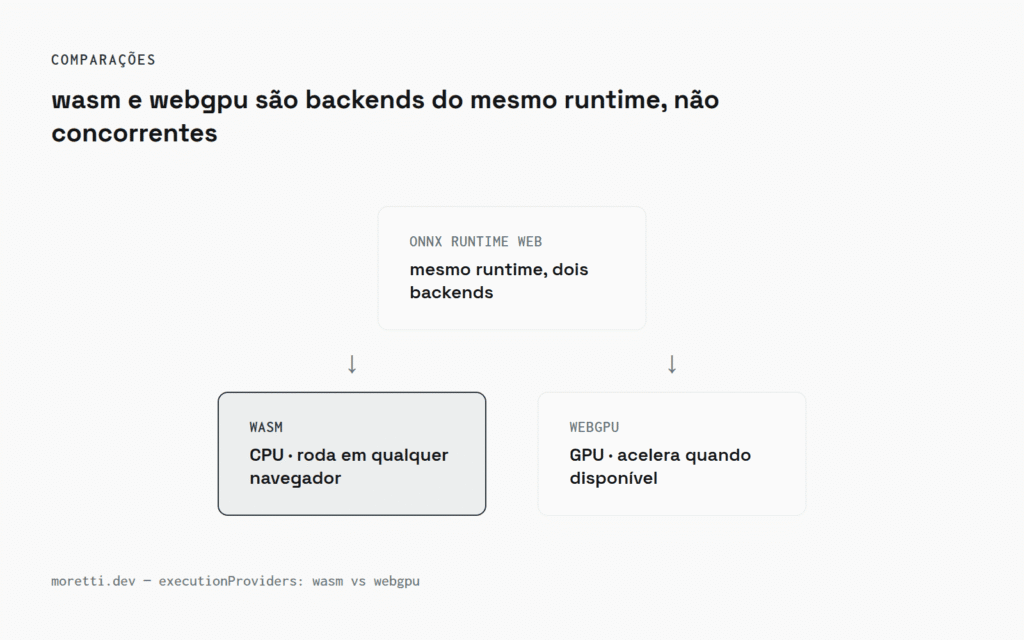
É comum ver WebAssembly e WebGPU apresentados como alternativas concorrentes. Na prática, dentro do ONNX Runtime Web, os dois são backends complementares do mesmo runtime: basta trocar a opção executionProviders entre wasm e webgpu para alternar entre CPU e GPU, sem reescrever o modelo nem a lógica da aplicação. WebAssembly garante que o código roda em qualquer navegador moderno, com ou sem GPU dedicada. WebGPU acelera quando a GPU está disponível e o modelo se beneficia de paralelismo massivo. Um não substitui o outro. Um é a base; o outro é a otimização condicional.
Conclusão: a pergunta certa não é “quão rápido”, é “pra que tipo de tarefa”
A dúvida original ainda vale retomar: se o navegador só roda JavaScript, como um modelo de IA treinado em Python acaba rodando dentro de uma aba? A resposta não é “porque JavaScript ficou mais rápido”. WebAssembly não é uma versão turbinada de JavaScript, é um formato binário independente de linguagem, desenhado para ser um alvo de compilação seguro e portátil. ONNX não é um formato de arquivo qualquer, é um contrato que separa onde um modelo foi treinado de onde ele vai ser executado.
Os dois resolvem problemas ortogonais, criados em contextos diferentes, por equipes diferentes, e só quando combinados explicam por que hoje é tecnicamente viável, e comprovadamente em produção, rodar um modelo real dentro do navegador. Não como substituto de servidor. Como opção nova pra um conjunto específico de tarefas, onde o modelo é pequeno o bastante pra caber no hardware de quem está do outro lado da tela. O restante desta série mostra essa decisão sendo tomada, e testada, num caso concreto ainda em desenvolvimento.
Referências
- WebAssembly Core Specification, introdução formal: https://webassembly.github.io/spec/core/intro/introduction.html
- WebAssembly High-Level Goals (WebAssembly Community Group): https://webassembly.org/docs/high-level-goals/
- WebAssembly Roadmap (consenso de design, novembro de 2017): https://webassembly.org/roadmap/
- W3C Press Release, WebAssembly Core Specification como W3C Recommendation (dezembro de 2019): https://www.w3.org/2019/12/pressrelease-wasm-rec.html.en
- MDN, WebAssembly Concepts: https://developer.mozilla.org/en-US/docs/WebAssembly/Guides/Concepts
- ONNX Runtime, WebGPU Execution Provider: https://onnxruntime.ai/docs/tutorials/web/ep-webgpu.html
- ONNX Runtime Web, código-fonte (compilação via Emscripten): https://github.com/microsoft/onnxruntime/tree/main/js/web
- Meta Engineering, “ONNX V1 released” (dezembro de 2017): https://engineering.fb.com/2017/12/08/ml-applications/onnx-v1-released/
- Mozilla Hacks, “Where is WebAssembly now and what’s next?” (fevereiro de 2017): https://hacks.mozilla.org/2017/02/where-is-webassembly-now-and-whats-next/
- Mozilla Press Center, “WebAssembly support now shipping in all major browsers” (novembro de 2017): https://blog.mozilla.org/press/2017/11/webassembly-support-now-shipping-in-all-major-browsers/
- Luke Wagner, anúncio original do asm.js (março de 2013): https://blog.mozilla.org/luke/2013/03/21/asm-js-in-firefox-nightly/
- TensorFlow Blog, “Introducing the WebAssembly backend for TensorFlow.js” (março de 2020): https://blog.tensorflow.org/2020/03/introducing-webassembly-backend-for-tensorflow-js.html
- v8.dev, “Fast, parallel applications with WebAssembly SIMD”: https://v8.dev/features/simd
- web.dev, “WebAssembly Threads ready to try in Chrome 70”: https://web.dev/wasm-threads/
- Jangda et al., “Not So Fast: Analyzing the Performance of WebAssembly vs. Native Code”, USENIX ATC’19: https://www.usenix.org/system/files/atc19-jangda.pdf
- TechCrunch, anúncio do ONNX (setembro de 2017): https://techcrunch.com/2017/09/07/facebook-and-microsoft-collaborate-to-simplify-conversions-from-pytorch-to-caffe2/
- Google Research, “Background Features in Google Meet, Powered by Web ML” (outubro de 2020): https://research.google/blog/background-features-in-google-meet-powered-by-web-ml/
Nota de transparência: este artigo foi produzido com auxílio de ferramentas de IA (pesquisa e redação), com revisão e decisões editoriais do autor.